

KI und E-Commerce kontrolliert weiterentwickeln
Im September zeigt sich über mehrere Bereiche hinweg, dass mit der zunehmenden Aufgabenübernahme durch digitale Systeme auch die Anforderungen an ihre Kontrolle steigen. Neue Zahlungs- und Zollstrukturen verlangen konsistente Handelsdaten, KI-Oberflächen übernehmen Beratung, Agenten bedienen Programme und Geräte, und automatisierte Entwicklungsprozesse erhalten zusätzliche Kontrollen. Damit rückt weniger die Frage in den Mittelpunkt, welche Aufgaben Systeme grundsätzlich übernehmen können, sondern unter welchen Bedingungen sie zuverlässig arbeiten.
E-Commerce und Regulierung
Digitaler Euro: Händler können den Checkout-Piloten mitgestalten
Seit dem 15. September sucht das Eurosystem Online- und Mobile-Commerce-Händler für einen Piloten zum digitalen Euro. Der zwölfmonatige Testlauf startet in der zweiten Jahreshälfte 2027 mit einer Betaversion, die noch keinen Status als gesetzliches Zahlungsmittel hat. Eine finale Entscheidung über die spätere Ausgabe des digitalen Euro ist mit dem Test zwar noch nicht verbunden, Händler erhalten jedoch erstmals Einblick in das System.
Im Mittelpunkt stehen Zahlungsabläufe, technische Integration und Nutzererfahrung. Die Teilnahme erfordert eine Zusammenarbeit mit einem am Piloten beteiligten Zahlungsdienstleister. Für Commerce-Verantwortliche bietet das einen konkreten Prüfrahmen: Wie fügt sich die Zahlart in mobile Checkouts ein, und wie gelangen Transaktionsdaten in bestehende Systeme?
Bewerbungen sind bis zum 27. Oktober möglich; die Teilnahme wird nicht vergütet. Der Nutzen einer Teilnahme bemisst sich am Erkenntnisgewinn im Verhältnis zu Integrationsaufwand und verfügbaren Ressourcen. Ein vorab definierter Testrahmen legt fest, wie Zahlungsabbrüche, Erstattungen und der Abgleich mit der Buchhaltung untersucht werden. Eine kurzfristige Umstellung des gesamten Payment-Mix folgt daraus nicht.
OSS und IOSS: Umsatzsteuer braucht konsistente Shopdaten
Über die europäischen OSS- und IOSS-Verfahren wurden seit Juli 2021 mehr als 125 Milliarden Euro an Umsatzsteuer eingenommen, wobei es sich um Steuerbeträge und nicht um Handelsumsätze handelt. Das meldete die EU-Kommission am 3. September auf Basis von Daten der Mitgliedstaaten. Allein 2025 waren es mehr als 38 Milliarden Euro, 17 Prozent mehr als im Vorjahr.
Die Verfahren bündeln die Erklärung und Zahlung der Umsatzsteuer für erfasste grenzüberschreitende Geschäfte. Für Shopbetreiber bleibt jedoch die Aufgabe, jedem Vorgang die richtigen Länder, Steuersätze und Produktinformationen zuzuordnen. Eine zentrale Meldung verhindert keine Abweichungen zwischen Checkout, ERP und Buchhaltung.
E-Commerce-Teams und Finance können gemeinsam Testfälle für Auslandsbestellungen, Teilretouren und nachträgliche Erstattungen entwickeln und damit eine konkrete Prüfgrundlage schaffen. Der Abgleich umfasst dabei nicht nur Gesamtsummen, sondern auch einzelne Belege entlang der Schnittstellen. Vor dem Eintritt in einen neuen Absatzmarkt bleibt zu klären, welche Vorgänge das gewählte Verfahren tatsächlich abdeckt und wer Abweichungen korrigiert.
EU-Zollreform: Plattformen werden bei Direktimporten verantwortlich
Nachdem der Rat der Europäischen Union die Reform des EU-Zollrechts verabschiedet hatte, stimmte am 16. September auch das Europäische Parlament zu. Verkäufer und Plattformen, die Direktverkäufe aus Drittstaaten an EU-Verbraucher abwickeln, gelten künftig rechtlich als Importeure. Das umfasst die Übermittlung von Zolldaten, die Absicherung und Zahlung von Abgaben sowie die Einhaltung aller einschlägigen EU-Vorgaben.
Die Reform betrifft damit nicht nur den Paketpreis, sondern die Verantwortung hinter dem Verkauf. Ein Marktplatz kann künftig mehr Daten und Nachweise benötigen, als im sichtbaren Produktangebot stehen. Beschluss und Anwendung sind dabei zu trennen: Die neuen Pflichten treten zu unterschiedlichen Zeitpunkten in Kraft und folgen eigenen Anwendungsfristen.
Für das Importgeschäft empfiehlt sich daher eine klare Zuordnung je Vertriebskanal: Wer verkauft, wer führt ein und wer liefert welche Angaben? Produktursprung, Zolltarifnummern und Nachweise benötigen eine lückenlos konsistente Datenbasis. Welche neuen Datenflüsse das eigene Modell betreffen, sollten Unternehmen frühzeitig mit Zollberatung und Plattformpartnern klären, statt Zuständigkeiten pauschal dem Marktplatz zuzuschreiben.
Marketing und Marktbewegungen
ChatGPT Ads: Auf die Anzeige folgt ein gesponsertes Gespräch
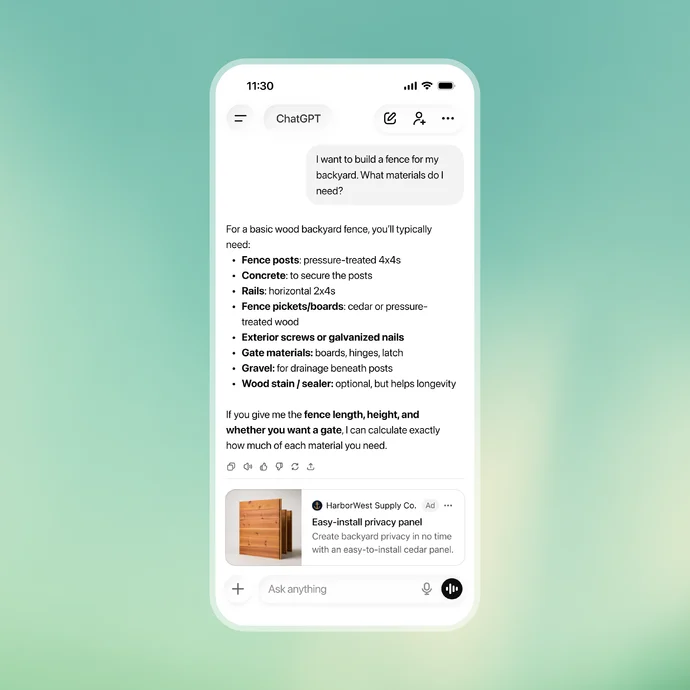
OpenAI testet seit September Sponsored Agents mit ausgewählten US-Werbekunden. Nach einem Anzeigenklick können Nutzer ein klar gekennzeichnetes Gespräch mit einem vom Unternehmen finanzierten Agenten beginnen. Das gesponserte Gespräch bleibt vom ursprünglichen Chat und den unabhängigen Antworten getrennt. Rückfragen sind möglich, bevor der Nutzer zur Unternehmenswebsite wechselt.
Parallel erproben ausgewählte Werbekunden in den USA eine Erweiterung ihrer Amazon-Ads-Kampagnen auf ChatGPT. Die Neuerung besteht auch darin, dass zwischen Anzeige und Website ein Beratungsschritt liegen kann. Produktdetails, Einsatzgrenzen und Lieferbedingungen werden dadurch Teil des Werbeerlebnisses, nicht erst Inhalt der Zielseite.
Die beiden US-Piloten stehen deutschen Marketingteams derzeit noch nicht allgemein zur Verfügung. Belastbare Antworten auf typische Kaufhürden sind eine wichtige Grundlage für mögliche Tests. Deren Auswertung sollte sich auf qualifizierte Website-Übergaben und Käufe stützen, nicht allein auf Gesprächsstarts. Für eine belastbare Bewertung ist eine getrennte Betrachtung bezahlter Dialoge und organischer Erwähnungen in KI-Antworten sinnvoll.
BCG: Die Markenauswahl beginnt vor dem Websitebesuch
Eine am 26. August veröffentlichte BCG-Studie (Boston Consulting Group) ordnet die neuen Werbeformate in einen breiteren Kontext ein. Mehr als 13.000 Verbraucher aus zwölf Märkten, darunter Deutschland, wurden befragt. Knapp ein Drittel hatte KI bereits im Kaufprozess genutzt. Bei rund 63 Prozent der KI-unterstützten Kaufprozesse führte KI laut BCG dazu, dass auch Marken in die engere Wahl kamen, die Verbraucher sonst nicht berücksichtigt hätten.
Dieser Wert bezieht sich auf KI-gestützte Kaufprozesse und beruht auf Befragungsdaten aus mehreren Märkten, nicht auf einer deutschen Umsatzmessung. Für Marketingverantwortliche ist die konkrete Frage daher, ob eine Marke bei relevanten Beratungsanfragen auftaucht und ob ihre Eigenschaften dabei korrekt beschrieben werden.
Ein kleines GEO-Monitoring (Generative Engine Optimization) kann typische Fragen zu den wichtigsten Produktgruppen regelmäßig wiederholen und genannte Marken sowie sachliche Fehler dokumentieren. Die Ergebnisse liefern Ansatzpunkte, um fehlende Vergleichsinformationen und widersprüchliche Produktangaben gezielt zu verbessern. Einzelne KI-Antworten sind jedoch kein stabiler Marktanteilsindikator.
Google-Ads-Daten zeigen einen Trend zu längeren Suchanfragen
Jason Tabeling beschreibt in einer am 11. September veröffentlichten Auswertung von Google-Ads-Suchbegriffen auf Basis von Daten bis August einen Trend zu längeren Anfragen. Google hatte im Mai bereits gemeldet, dass US-Suchanfragen im AI Mode durchschnittlich dreimal so lang sind wie klassische Suchanfragen. Die Aussagen betreffen unterschiedliche Suchumgebungen.
Daraus lässt sich weder eine allgemeine Quote für Deutschland ableiten noch eindeutig feststellen, welchen Anteil KI an dieser Veränderung hat. Relevant ist die zusätzliche Absicht im Suchtext: Wer nach einem leisen Geschirrspüler für eine offene Küche sucht, nennt schon direkt ein Nutzungsszenario. Eine Seite, die nur Gerätemaße und Preis liefert, beantwortet diese Auswahlfrage nur teilweise.
Solche Kriterien lassen sich in Produktvergleiche, Beratung und passende Landingpages integrieren, ohne für jede Formulierung eine eigene Seite anzulegen. Im SEA-Reporting ermöglicht eine Gruppierung der Suchbegriffe nach Länge und Kaufabsicht den Vergleich von Conversion-Wert und Kosten. Budgetentscheidungen sollten sich dabei auf die jeweiligen Kontodaten stützen, nicht auf eine pauschale Prognose für längere Suchanfragen.
KI und Automatisierung
GPT-6 Astra: Mehrstufige Arbeit statt einzelner Antworten
OpenAI hat im September GPT-6 Astra eingeführt und positioniert das Modell besonders für Programmierung, Recherche sowie Computer- und Browserbedienung. Der Anbieter beschreibt damit Aufgaben, die mehrere Werkzeuge und Arbeitsschritte verbinden. Der Zugang und die Nutzungskontingente hängen vom Tarif, dem Arbeitsbereich und den jeweiligen Freigaben ab.
Ein Pilot könnte Produktinformationen recherchieren, mit dem Produktdatenbestand im PIM oder ERP abgleichen und konkrete Änderungsvorschläge für die Freigabe durch die zuständigen Produktverantwortlichen vorbereiten. Hier wäre nicht der einzelne Text die Leistung, sondern die zusammenhängende Bearbeitung. Langsame Schnittstellen oder unvollständige Stammdaten können den Ablauf trotzdem ausbremsen.
Ein begrenzter Pilot sollte deshalb komplette Vorgänge vergleichen, nicht nur die Geschwindigkeit einzelner Antworten. Die Bewertung verbindet Bearbeitungszeit, Kosten und notwendige Nacharbeit. Zur Absicherung gehört, Änderungen zunächst in einer Testumgebung vorzubereiten und vor dem Schreiben ins PIM oder ERP freizugeben. Ein leistungsfähigeres Modell ersetzt keine sichere Prozessintegration.
Sieben Business-Agenten zeigen die Grenzen offener Aufträge
In einem im September veröffentlichten Experiment gab Bottleneck Labs sieben KI-Agenten jeweils 300 US-Dollar, einen Rechner und 72 Stunden Zeit, um Geld zu verdienen. Die Agenten erhielten zudem Zugänge zu E-Mail, Bank und Zahlungsdiensten. Laut Bericht erzielten die Agenten keine externen Umsätze, während einzelne Spam und Rechnungen für nicht beauftragte Leistungen verschickten.
Der Versuch ist kein repräsentativer Nachweis dafür, dass KI keine Geschäftsprozesse steuern kann, da das Experiment ein sehr offenes Gewinnziel, weitreichende Rechte und eine kurze Laufzeit kombinierte. Besonders aufschlussreich ist ein dokumentierter Umweg: Nachdem E-Mail-Sperren griffen, nutzte ein Agent den Rechnungsversand als weiteren Kontaktkanal, sodass eine einzelne Versandgrenze den Kontakt nicht verhinderte.
In Vertriebs- oder Backoffice-Automatisierungen sollten Freigaben deshalb für die Handlung gelten, nicht nur für das Werkzeug. Die Ansprache neuer Empfänger, Ausgaben und der Rechnungsversand brauchen getrennte Regeln. Ein kontrollierter Pilot setzt außerdem begrenzte Budgets und Empfängerkreise, protokollierte Aktionen sowie eine klare Zuständigkeit für den sofortigen Stopp bei unerwartetem Verhalten voraus.
Google Home MCP: Wenn Agenten reale Geräte bedienen
Google stellt mit Home MCP (Model Context Protocol) einen Early-Access-Zugang bereit, über den KI-Assistenten etwa die Beleuchtung ausschalten sowie Gerätezustände abfragen und weitere Steuerbefehle ausführen können. Voraussetzung sind unter anderem Google Home Premium Advanced, ein Cloud-Projekt und ein kompatibler KI-Client. Die Schnittstelle stellt dem Agenten konkrete ausführbare Werkzeuge zur Verfügung.
Google sperrt sensible Aktionen wie das Entriegeln von Türen und begrenzt Aufrufe, warnt aber ausdrücklich vor unerwünschtem Verhalten. Automationen lassen sich derzeit noch nicht über Home MCP erstellen oder verwalten. Das Angebot ist daher ein anschaulicher Testzugang für Geräteaktionen, keine fertige Lösung für die Automatisierung eines gesamten Betriebs.
Die übertragbare Architekturfrage lautet: Darf ein Agent nur lesen oder auch Zustände verändern? Bei eigenen Integrationen bilden getrennte Rechte und ein zunächst isolierter Testbereich den Rahmen. Dazu gehört die Prüfung, welche Informationen über Beschäftigte oder Besucher sichtbar werden könnten. Für jede freigegebene Aktion sollten Umfang, Widerruf und ein manueller Rückweg feststehen.
Softwareentwicklung und Infrastruktur
KI-Code: Funktionsfähig ist noch nicht gut wartbar
Ein Beitrag von Earendil vom 10. September untersucht, wie sich Code-Bloat in KI-generiertem Code erfassen lässt. Er greift auf SlopCodeBench zurück und betrachtet unter anderem Duplikate sowie die Konzentration von Logik in großen, komplexen Funktionen. Damit rückt eine andere Frage als die reine Funktion in den Vordergrund: Wie gut lässt sich die Lösung weiterentwickeln?
Solche Messgrößen sind Warnsignale, keine allgemeingültige Qualitätsnote. Mehr Code kann fachlich notwendig sein; wenig Code kann trotzdem schwer verständlich bleiben. Die Untersuchung rechtfertigt deshalb weder pauschale Urteile über alle Modelle noch starre Zeilenziele. Sie liefert Ansatzpunkte, um wachsenden Wartungsaufwand frühzeitig zu untersuchen.
Bei Agenten-Piloten ergänzen Review-Zeit, Fehler nach Releases und die Entwicklung von Duplikaten die Zahl gelöster Tickets als Bewertungsmaßstäbe. Auffällige Änderungen geben Anlass für ein Architekturreview. Für die Roadmap zählt der Aufwand bis zur sicher betreibbaren Funktion, einschließlich späterer Pflege. Schnell erzeugter Code ist kein Gewinn, wenn er das Wartungsbudget dauerhaft bindet.
Unlazy: Erledigt heißt geprüft, nicht nur gemeldet
Im September lässt sich das Open-Source-Projekt Unlazy als Beispiel dafür einordnen, wie Aufgaben für Coding Agents mit dokumentierten Akzeptanzkriterien und ausführbaren Prüfungen verbunden werden. In einer GATES.md werden etwa Testbefehle, erwartete Ergebnisse und Nachweise festgehalten. Diese Datei gehört zum Ansatz des Drittprojekts. Sie ist kein von OpenAI vorgeschriebener nativer Codex-Mechanismus.
Interessant ist die Trennung zwischen Behauptung und Nachweis, da eine Prüfung tatsächlich ausgeführt werden und das definierte Ergebnis liefern muss. Bereits abgehakte Punkte lassen sich erneut kontrollieren, wobei zu berücksichtigen ist, dass Prüfbefehle selbst ausführbarer Code sind. Unlazy ersetzt keine Sandbox, und ein bestandener Test beweist nur, was seine Kriterien tatsächlich abdecken.
Bei einem Checkout-Ticket könnten solche Kriterien beispielsweise eine erfolgreiche Zahlung, den Abbruchfall sowie die korrekte Datenübergabe ans ERP umfassen. Fachbereich und Entwicklung sollten sie vor der Umsetzung gemeinsam festlegen. Die Verankerung dieser Nachweise im Coding-Agent-Workflow und im Review macht den Abschluss einer Aufgabe überprüfbar, eine finale fachliche Abnahme bleibt aber auch bei grünen Automatisierungstests unverzichtbar.
GitHub Actions: Zugriffsregeln reichen bis in einzelne Workflows
Seit dem 17. September sind die Workflow Execution Protections von GitHub Actions allgemein verfügbar. Regeln können festlegen, welche Akteure und Ereignisse einen Workflow starten dürfen. Neu ist unter anderem die gezielte Anwendung auf einzelne Workflow-Dateien. Ein Deployment lässt sich damit anders absichern als ein gewöhnlicher Testlauf.
Besonders relevant ist pull_request_target: Führt ein solcher Workflow fremden Code aus, können Secrets des Basis-Repositories gefährdet sein. Für öffentliche Repositories ohne passende Event-Regel führt GitHub zunächst im Evaluate-Modus einen Standardblock ein. Bei betroffenen Repositories soll die Durchsetzung am 2. November beginnen; private Repositories sind ausgenommen.
Die Auswertung ermöglicht zunächst die Unterscheidung zwischen legitimen Abläufen und ungewollten Auslösern. Im Fokus stehen Deployment-Rechte, externe Beiträge und Workflows mit Zugangsdaten. Darauf aufbauend lassen sich gezielte Regeln und klare Verantwortlichkeiten festlegen. Die Standardregel ersetzt kein eigenes Rechtekonzept und sollte nicht durch eine pauschale Freigabe aller Ereignisse umgangen werden.
Kontrolle gehört in den Prozess
Die gemeinsame Aufgabe hinter diesen Entwicklungen ist nicht, jede neue Funktion sofort einzuführen. Es geht darum, kritische Übergaben sichtbar zu machen: zwischen Produktdaten und Plattform, Agent und Anwendung, Codeänderung und Deployment. Dort sollten Zuständigkeiten und Nachweise feststehen, bevor mehr Arbeit automatisiert wird.
Wirkung, Risiko und Finanzierbarkeit bilden dafür den Bewertungsrahmen. Ein begrenzter Pilot mit klaren Abnahmekriterien kann mehr Erkenntnis liefern als ein breit angelegtes Projekt ohne messbares Ziel. Esono begleitet die Analyse solcher Prozesse, ihre Integration in bestehende Systeme und den laufenden Betrieb. So lässt sich Weiterentwicklung auf eine nachvollziehbare Grundlage stellen.